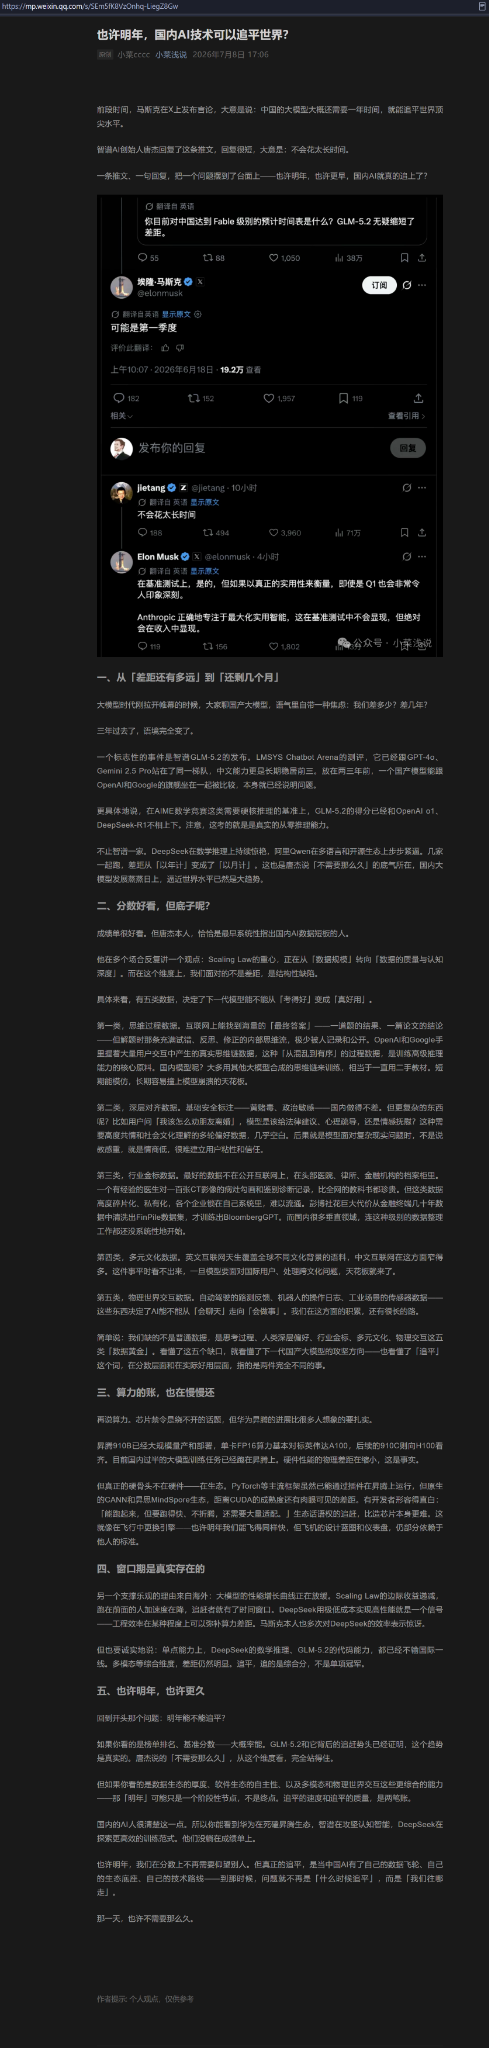
前段时间,马斯克在 X 上发布言论,大意是说:中国的大模型大概还需要一年时间,就能追平世界顶尖水平。
硅谷 AI 创始人也表达过类似判断。回复很短,大意是:不会花太长时间。
一条推文、一句回复,把一个问题摆到了台面上——也许明年,国内 AI 就真的追上了?
一、从“差距还有多远”到“还剩几个月”
大模型时代刚拉开帷幕的时候,大家最常问的是“大模型,距离世界还差一种排序,我们差多少?差几年?”三年过去了,语境完全变了。
一个标志性的事件是智谱 GLM-5.2 的发布。LMSYS Chatbot Arena 的测评把它放到了全球前列,而中文能力更是长期霸榜前三。放在两三年前,一个国产模型能跟 OpenAI 和 Google 的旗舰模型一起被比较,本身就已经说明问题。
更具体来说,在 AI 编程等赛道,这些国内模型已经开始在具体能力上形成竞争力。几家一起追、差距从“以年计”变成“以月计”,这是最直观的变化。
二、分数好看,但底子呢?
成绩单很好看。但面高不大,恰恰是最早系统指出国内 AI 数据短板的人。他在多个场合反复讲一个观点:Scaling Law 的核心,正在从“数据规模”转向“数据的质量与认知深度”。而在这个维度上,我们面对的不是追赶,是结构性缺陷。
具体来看,公开数据决定了下一代模型能不能从“背得好”变成“真的会用”。不同类型数据的稀缺程度完全不同:互联网公开知识相对充足,但高质量专业过程数据、行业复合链条数据、多语言文化数据,以及真实世界的机器与工业现场数据,仍然是明显短板。
这意味着:我们缺的不只是训练数据,是思考过程、人类深层偏好、行业全貌、多元文化、物理交互这些更综合的能力。更麻烦的是,这些东西不是有个 token 就够了。
三、算力的账,也在慢慢还
两年前,芯片禁令是绕不开的话题。但华为昇腾的进展让很多人想象空间扎实了一些。目前国内过半的大模型训练任务已经部署在昇腾上,硬件性能的提升是确定的,这是事实。
但真正的竞争还不只在单点算力,而在芯片之外的工程化、算力调度、生态与软件适配。这个短板在补,但仍然需要时间。
四、窗口期是真实存在的
另一个变量反而来自非常意外:大模型的性能增长曲线正在放缓。Scaling Law 的边际收益递减,跑在前面的人加速越来越难,追赶者就有了时间窗口。
DeepSeek 用极低成本实现高性能就是一个信号——工程效率在某种程度上可以弥补纯算力差距。马斯克本人也多次对 DeepSeek 的效率表示惊讶。
但也要诚实地说:单点能力上,DeepSeek 的数学推理、GLM-5.2 的代码能力都已经不错;多模态等综合维度,差距仍然明显。追平不是单项冠军,而是整体成熟。
五、也许明年,也许更久
回到开头那个问题:明年能不能追平?
如果你看的只是排行榜,悬念参数,大概率能。但是如果看的是高质量数据、算力底座、开源生态、工程化、以及能不能真正稳定支撑生产场景,这个结论就要复杂得多。
但如果你真的要数据生态的厚度、软件生态的自主性、以及多模态和物理世界交互这些更综合的能力——那“明年”可能只是一个阶段性节点,不是终点。
国内的 AI 从高速追赶一点一点追到能看到对手后视镜,是我们这批人见证的过程。也许明年,我们在分数上不再需要仰望别人,但真正的追平,是当中国 AI 有了自己的数据飞轮、自己的生产级生态、自己的技术路线——到那时候,问题就不再是“什么时候追平”,而是“我们往哪走”。
那一天,也许不需要那么久。
作者提示:个人观点,仅供参考。
原文截图